

Rastreamento de Corpo + Mãos Combinado: Animação de Personagem Completo em Uma Única Tomada
A maioria dos pipelines de captura de movimento trata um ser humano como três problemas separados. O corpo passa por um sistema, as mãos por outro, o rosto por um terceiro. Depois alguém passa uma tarde em uma timeline tentando fazer os três concordarem entre si. Este artigo trata de pular tudo isso — capturando corpo, mãos e rosto em uma única passada unificada a partir de um vídeo comum, e por que um solve combinado produz animação fundamentalmente melhor do que a soma de três boas camadas.
O que você vai aprender
- O custo oculto da captura de movimento em camadas
- O problema da emenda no pulso que ninguém avisa
- O que um solve unificado realmente faz de diferente
- O trade-off de enquadramento — e como vencê-lo
- Capturando tudo de uma vez com QuickMagic
- Fluxo de trabalho de produção passo a passo
- Retargeting de movimento de um esqueleto combinado
- Onde a captura em uma única tomada compensa mais
- Preenchendo lacunas com texto para animação 3D
- Comparação: QuickMagic, Animate 3D, SayMotion e outros
- Perguntas frequentes
O Custo Oculto da Captura de Movimento em Camadas
A captura de movimento tradicional cresceu de forma modular por razões práticas. Sistemas ópticos rastreavam bem marcadores grandes no corpo, mas não conseguiam resolver os dedos, então luvas foram acopladas. Rostos precisavam de uma câmera montada na cabeça porque o detalhe facial é medido em milímetros. Cada subsistema era excelente isoladamente e cada um vinha com seu próprio gravador, seu próprio relógio e seu próprio espaço de coordenadas.
Essa modularidade cobrava um imposto que a maioria das pessoas só descobre depois do primeiro projeto:
- Alinhamento de timecode. Três dispositivos de gravação significa três relógios. Genlock ajuda, mas setups de consumo e prosumer rotineiramente oscilam um ou dois frames ao longo de uma tomada longa — o suficiente para um estalo de dedos aparecer visivelmente depois do braço que o produziu.
- Incompatibilidade de espaço de coordenadas. Os dados das mãos são capturados em relação ao pulso, os dados do corpo em relação ao quadril ou à origem do mundo. Combiná-los exige uma cadeia de transformações, e qualquer erro ali se propaga pelos dedos.
- Passadas separadas de limpeza. Você remove o ruído do corpo, depois remove o ruído das mãos, e então descobre que suas configurações de suavização discordavam e o pulso agora "pula".
- Trabalho de mesclagem. Em um projeto indie típico, mesclar e reconciliar camadas consome mais horas do que a própria sessão de captura.
- Amplificação de regravações. Se um subsistema falhar no meio da tomada, você regrava tudo, porque regravações parciais não vão se alinhar com as camadas que você manteve.
Nada disso é culpa de ninguém. É a arquitetura funcionando como foi projetada. Mas significa que o gargalo real na animação de personagens nunca foi "conseguimos capturar movimento" — era "conseguimos fazer três capturas da mesma pessoa concordarem".
Um performer não tem timelines separadas de corpo, mãos e rosto. Ele tem um sistema nervoso produzindo uma performance coordenada. Cada fronteira de camada que você introduz é um lugar onde essa coordenação pode se perder.
O Problema da Emenda no Pulso Que Ninguém Avisa
Isso merece uma seção própria, porque é o artefato mais comum em captura em camadas e o mais difícil de explicar a um cliente que vê que algo está errado, mas não consegue nomear o que é.
Aqui está o mecanismo. Seu solve de corpo produz um valor de rotação para a articulação do pulso, derivado da orientação do antebraço e do plano da mão. Seu solve de mão também produz um valor de rotação para essa mesma articulação do pulso, derivado de sua própria visão da palma. Ambos são estimativas razoáveis. Quase nunca são idênticas.
Quando você mescla, precisa escolher uma, e qualquer escolha cria um problema:
Usar o pulso do corpo
- A conexão antebraço-mão permanece suave
- Os dedos herdam um pulso que discorda de como foram capturados
- As pegadas desviam dos objetos; o plano da mão gira sutilmente de forma errada
Usar o pulso da mão
- A relação dedos-palma permanece correta
- Uma descontinuidade rotacional visível aparece no antebraço
- É lida como um "tique de boneca quebrada" durante movimentos rápidos
Estúdios resolvem isso com uma região de mistura — ponderando entre as duas soluções através do pulso e da parte inferior do antebraço. Funciona, exige habilidade, e é mais uma coisa para ajustar por cena. Misture apertado demais e você tem um "pop"; misture solto demais e a rotação do antebraço se espalha até o cotovelo.
Um solve combinado contorna todo o argumento. Há apenas uma rotação de pulso porque houve apenas um solve. A emenda não precisa ser corrigida porque ela não existe.
O Que um Solve Unificado Realmente Faz de Diferente
Seria fácil assumir que "captura combinada" significa apenas rodar modelos de corpo e mãos simultaneamente e grampear as saídas. A captura de movimento por IA moderna faz algo mais útil do que isso.
Um esqueleto, uma otimização
Em vez de resolver corpo e mãos independentemente, o sistema ajusta um único modelo humano parametrizado — uma árvore cinemática completa do quadril até a coluna, ombros, braços, pulsos e cada articulação dos dedos — às evidências observadas na imagem. Os ângulos das articulações são estimados em conjunto, sujeitos à restrição de que todos pertencem ao mesmo corpo. Não há etapa de mesclagem porque nada jamais foi separado.
Compartilhamento de evidências entre regiões
Esta é a parte que realmente melhora a qualidade. Quando uma mão está parcialmente ocluída, um solve conjunto ainda pode restringi-la usando a orientação do antebraço, a posição do ombro e a pose do corpo — contexto físico que um modelo de mão isolado simplesmente não tem acesso. Por outro lado, posições de dedos claramente visíveis ajudam a desambiguar a rotação do antebraço, que é notoriamente difícil de estimar apenas com marcos do corpo porque o antebraço é aproximadamente cilíndrico.
Modelo temporal compartilhado
Uma única passada de suavização em todo o esqueleto significa que corpo e mãos são filtrados de forma consistente. Chega de descobrir que suas mãos parecem nítidas enquanto os braços parecem lentos, ou que uma correção de tremor em uma região introduziu atraso em relação a outra.
Plausibilidade anatômica como restrição
Um modelo unificado pode garantir que o resultado permaneça um ser humano fisicamente possível — comprimentos de membros permanecem constantes, articulações permanecem dentro do intervalo, mãos permanecem conectadas aos braços em ângulos sensatos. Pipelines em camadas não têm mecanismo para impor isso através da fronteira, e é exatamente por isso que ângulos impossíveis de pulso são um artefato tão comum na captura em camadas.
O Trade-off de Enquadramento — E Como Vencê-lo
Aqui está a restrição de engenharia honesta no coração da captura em uma tomada, e a coisa que a maioria dos tutoriais pula por ser inconveniente.
Para capturar o corpo, você precisa do performer inteiro no quadro. Para capturar os dedos, você precisa de pixels suficientes nas mãos para resolver articulações individuais. Esses dois puxam em direções opostas. Enquadre aberto para corpo inteiro e cada mão pode ocupar 40×40 pixels em um frame 1080p — mal o suficiente para uma rede localizar 21 marcos. Enquadre apertado nas mãos e você perdeu o corpo completamente.
Esse trade-off é real e nenhum marketing o dissolve. Mas é muito administrável uma vez que você entende as alavancas.
| Alavanca | Recomendação | Por que funciona |
|---|---|---|
| Resolução de captura | Grave em 4K, mesmo que você entregue em 1080p | Quadruplica os pixels nas mãos com enquadramento idêntico. A mudança de maior impacto disponível. |
| Disciplina de enquadramento | Preencha o quadro verticalmente; cabeça perto do topo, pés perto da base | A maioria das pessoas fica longe demais e desperdiça 40% do quadro com teto e chão. |
| Proporção de tela | Grave na vertical (9:16) para performances em pé | Um humano em pé é alto e estreito. O enquadramento vertical desperdiça muito menos pixels do que o paisagem. |
| Escolha da lente | Lente padrão, distância moderada — evite ultra- grande-angular | Lentes grande-angular introduzem distorção de barril que corrompe a estimativa de profundidade, especialmente nas bordas do quadro. |
| Envelope de gestos | Mantenha as mãos à frente do tronco, longe do contorno do corpo | Mãos em silhueta contra a própria roupa são muito mais fáceis de segmentar do que mãos sobrepostas ao peito. |
| Taxa de quadros | 60fps quando a iluminação permitir | Menos desfoque de movimento por frame. O desfoque destrói pequenos detalhes como pontas dos dedos muito antes de afetar o rastreamento do tronco. |
| Iluminação | Luz frontal ampla na altura do peito | As mãos viajam à frente do corpo e saem da iluminação na altura do rosto, ficando sombreadas exatamente quando importam. |
Aplique apenas as três primeiras — 4K, enquadramento vertical apertado, mãos à frente — e você normalmente obterá detalhe de dedos utilizável a partir de uma tomada de corpo inteiro com a câmera do celular. Esse é todo o truque.
Capturando Tudo de Uma Vez Com QuickMagic
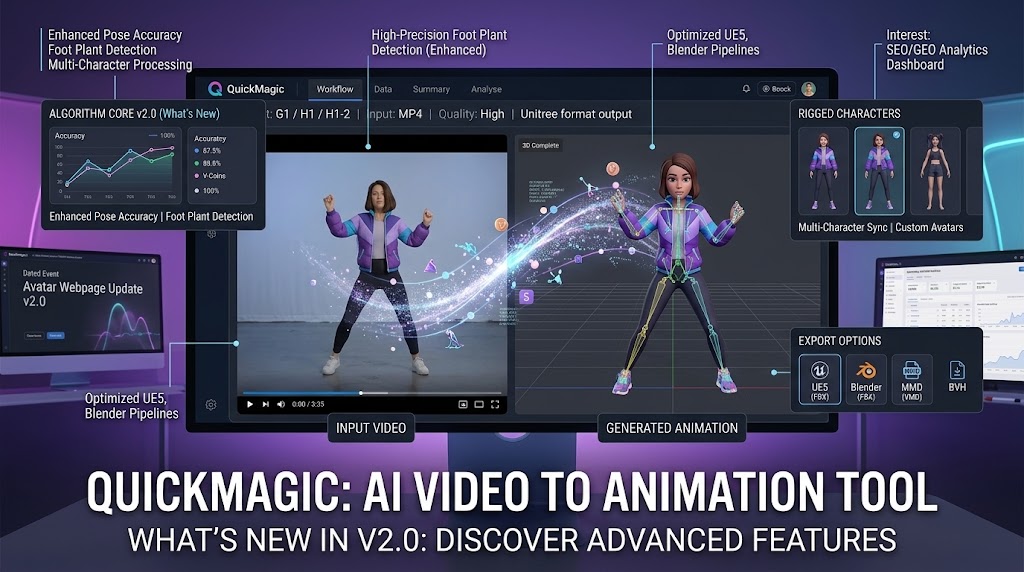
QuickMagic é uma plataforma de captura de movimento sem marcadores baseada em navegador que estima movimento de corpo, mãos e rosto a partir de imagens comuns em uma única passada e depois o converte em dados de animação 3D editáveis. Sem roupas especiais, sem marcadores, sem sensores, sem volume de múltiplas câmeras e nada para instalar localmente.
A comparação que importa:
Pipeline em camadas
- Traje de captura ou volume óptico
- Hardware separado de luvas
- Câmera facial montada na cabeça
- Três gravações para sincronizar
- Mesclar, misturar, corrigir emendas de pulso
- Horas de reconciliação por cena
Captura por IA em uma tomada
- Um celular ou webcam
- Um único arquivo de vídeo
- Corpo, mãos e rosto juntos
- Um esqueleto unificado na saída
- Sem emendas para misturar
- Minutos do upload à exportação
O plano gratuito é genuinamente utilizável para avaliar se isso se encaixa no seu pipeline e, notavelmente, não coloca a captura combinada atrás de um paywall:
| Plano gratuito | Detalhe |
|---|---|
| Créditos mensais | 50 V Coins, aproximadamente 50 segundos de vídeo processado, renovados mensalmente |
| Escopo de rastreamento | Opções de corpo, mãos e rosto — captura combinada incluída |
| Duração do clipe | Até 30 segundos por vídeo |
| Tamanho do upload | 50 MB |
| Exportação | FBX — compatível com Blender, Unity, Unreal, Maya, 3ds Max, MotionBuilder |
| Armazenamento | 15 dias, então baixe rapidamente e mantenha uma biblioteca local |
Os planos pagos ampliam tanto o volume quanto a matriz de exportação. O Basic (US$ 14,9/mês, 200 créditos, clipes de 60 segundos) desbloqueia FBX, BIP, VMD, OnlyFace, C4D, BVH, Unreal, Mixamo, Unity Anim, CC & iClone e Roblox. O Pro (US$ 49,9/mês, 1.000 créditos, clipes de 90 segundos, prioridade alta na fila) atende à produção regular, com os tiers Max e Studio para equipes com volume sustentado.
Capture corpo, mãos e rosto em uma única tomada
Captura de movimento por IA sem marcadores no navegador. Grátis para começar, sem cartão de crédito, sem hardware de mocap.
Experimente QuickMagic Grátis →Fluxo de Trabalho de Produção Passo a Passo
O processo completo de vídeo para animação 3D, do início ao fim. A primeira execução leva cerca de vinte minutos; as seguintes levam três.
- Planeje a performanceDecida antes de gravar se esta cena precisa de dedos. Se sim, coreografe os gestos para permanecerem à frente do tronco e evite poses com as mãos atrás das costas ou profundamente entrelaçadas. Dez segundos de planejamento economizam uma regravação.
- Configure câmera e iluminaçãoCelular em um tripé na altura do peito, orientação vertical, 4K/60 se disponível. Uma luz suave e ampla frontalmente na altura do peito, mais um preenchimento se você tiver. Fundo neutro. Corpo inteiro no quadro com o mínimo de espaço morto acima e abaixo.
- Grave com cabeça e caudaComece e termine com dois segundos de uma pose A neutra ou postura relaxada. Isso dá ao solver frames de inicialização limpos e dá a você pontos de corte limpos depois. Inclua várias tomadas em um único clipe contínuo para economizar créditos.
- Apare antes de enviarCorte apenas o segmento que você precisa. A cobrança acompanha segundos de vídeo processado, então um corte disciplinado multiplica diretamente o quanto você extrai de um plano.
- Envie e ative todos os rastreamentosSolte seu MP4, MOV, AVI ou WebM na interface de captura. Ative explicitamente o rastreamento de corpo, mãos e rosto juntos. Selecione o sujeito se várias pessoas estiverem visíveis, defina a taxa de quadros para corresponder ao seu pipeline alvo e escolha o modo de câmera estática ou em movimento de acordo com como você gravou.
- Inspecione a pré-visualização criticamenteOrbite a pré-visualização 3D e verifique três coisas especificamente: continuidade do pulso durante balanços de braço, comportamento dos dedos no momento mais rápido da tomada e contato dos pés se o performer estiver andando. Esses três expõem a maioria dos problemas.
- Aplique limpeza com moderaçãoUse os controles de suavização e pose para remover tremor residual. Resista à super-suavização — é o ferimento autoinfligido mais comum, transformando acentos nítidos em mingau. Corrija os 20% óbvios e deixe o resto para o seu DCC.
- Exporte para o seu pipelineFBX cobre Blender, Unity, Unreal, Maya e 3ds Max. VMD vai direto para o MikuMikuDance. BVH maximiza a interoperabilidade. Os predefinidos Unreal e CC/iClone pulam a conversão para esses alvos específicos.
- Faça retargeting e adicione camadasImporte, faça o retargeting para o seu personagem e então adicione camadas corretivas acima da animação assada em vez de editar os keyframes assados. Isso mantém a porta aberta para trocar por uma captura nova depois sem refazer suas correções.
Retargeting de Movimento de um Esqueleto Combinado
O retargeting de movimento é onde os dados capturados encontram seu personagem real. Uma captura combinada torna isso mais fácil e ligeiramente mais exigente ao mesmo tempo: mais fácil porque há um esqueleto coerente para mapear, mais exigente porque esse esqueleto inclui cadeias de dedos que seu rig alvo também precisa possuir.
Mapeie a hierarquia, não apenas os membros
Iniciantes mapeiam quadril, coluna, braços e pernas, apertam "retarget" e depois se perguntam por que os dedos estão estáticos. Capturas combinadas carregam cinco cadeias de dedos por mão — tipicamente três articulações cada. Seu mapeamento precisa incluir todas elas. A maioria das ferramentas de retargeting detecta automaticamente a nomenclatura padr