

Atualizado em julho de 2026
Captura de Movimento sem Marcadores Explicada: Como Funciona
A captura de movimento sem marcadores usa IA e visão computacional para transformar vídeos comuns em dados de animação 3D — sem necessidade de trajes, marcadores ou sensores. Este guia explica todo o pipeline, os principais modelos de IA, benchmarks de precisão, ferramentas de destaque e aplicações reais em 2026.
A captura de movimento sem marcadores é uma tecnologia que registra o movimento humano a partir de vídeos padrão e o converte em dados de animação 3D — sem exigir marcadores refletores, trajes com sensores ou câmeras especializadas. Ela utiliza visão computacional e modelos de aprendizado profundo para detectar articulações do corpo, inferir a pose 3D e gerar dados de animação esquelética que podem alimentar personagens digitais em jogos, filmes, RV e robótica.
Em 2026, a captura de movimento sem marcadores deixou de ser uma pesquisa experimental para se tornar uma ferramenta prática de produção. Ferramentas como QuickMagic, Move.ai, Plask e DeepMotion permitem que criadores enviem um vídeo gravado com celular e recebam arquivos de animação FBX ou BVH limpos em minutos. Este guia explica exatamente como a tecnologia funciona, os modelos de IA por trás dela, onde ela se destaca e onde ainda apresenta limitações.
O Que é Captura de Movimento sem Marcadores?
O termo "sem marcadores" se refere à ausência de marcadores físicos no corpo do performer. Em vez de rastrear pontos refletores, o modelo de IA identifica pontos-chave anatômicos — ombros, cotovelos, punhos, quadris, joelhos, tornozelos e muito mais — diretamente dos dados dos pixels. Esses pontos-chave formam um esqueleto digital que espelha os movimentos do performer quadro a quadro.
A captura sem marcadores se divide em três categorias, dependendo da configuração da câmera:
| Tipo | Câmeras Necessárias | Precisão | Caso de Uso Típico |
|---|---|---|---|
| Sem marcador com câmera única | 1 câmera RGB (celular, webcam) | Moderada | Jogos independentes, conteúdo de mídia social, prototipagem |
| Sem marcador com múltiplas câmeras | 2-8 câmeras RGB sincronizadas | Alta | Efeitos visuais de cinema, análise esportiva, pesquisa |
| Sem marcador com câmera de profundidade | 1+ câmera RGB-D (Kinect, RealSense) | Moderada-Alta | RV/RA, instalações interativas, avaliação clínica |
Como Funciona a Captura de Movimento sem Marcadores: O Pipeline de 5 Etapas
1 Entrada de Vídeo e Extração de Quadros
O processo começa com um arquivo de vídeo padrão. O sistema descomprime o vídeo em quadros individuais — tipicamente 24, 30 ou 60 quadros por segundo. Cada quadro é uma imagem estática que a IA analisará independentemente antes que a suavização temporal os una em um movimento contínuo.
Considerações importantes nesta etapa:
- Resolução: Resoluções mais altas (1080p ou superior) fornecem mais dados de pixel para o estimador de pose, melhorando a precisão dos pontos-chave
- Taxa de quadros: Taxas de quadros mais altas capturam movimentos rápidos com menos desfoque de movimento. QuickMagic suporta entrada de 24/30/60/120 FPS para diferentes necessidades de produção
- Iluminação: Iluminação difusa e uniforme produz os resultados mais confiáveis. Sombras fortes e contraluz podem confundir a detecção de pontos-chave
- Estabilidade da câmera: Câmeras estáticas geram dados mais limpos do que câmeras em movimento, embora sistemas avançados como QuickMagic suportem filmagens com câmera em movimento com modos de rastreamento global
2 Estimativa de Pose 2D
Esta é a etapa central da IA. Um modelo de aprendizado profundo analisa cada quadro do vídeo e prevê as coordenadas 2D em pixels dos pontos-chave anatômicos do corpo humano. O modelo foi treinado com milhões de imagens rotuladas mostrando humanos em diversas poses, roupas e ambientes.
O modelo processa a imagem através de uma rede neural convolucional (CNN) que aprendeu a reconhecer padrões visuais correspondentes às partes do corpo. Para cada ponto-chave (por exemplo, "cotovelo esquerdo"), o modelo gera um mapa de calor de probabilidade indicando onde aquela articulação está mais provavelmente localizada na imagem. O pico de cada mapa de calor torna-se a coordenada 2D final.
Contagens de pontos-chave comuns por modelo:
- MoveNet (Google): 17 pontos-chave — apenas as principais articulações
- OpenPose (CMU): 25 pontos-chave do corpo + 70 faciais + 21 por mão
- MediaPipe BlazePose (Google): 33 pontos-chave de corpo inteiro, incluindo mãos e pés
- HRNet (Microsoft): 17 pontos-chave com a maior precisão publicada no benchmark COCO
Duas abordagens arquiteturais lidam com a detecção de múltiplas pessoas: top-down (detecta cada pessoa primeiro, depois estima a pose individualmente — mais preciso, porém mais lento) e bottom-up (detecta todas as partes do corpo de uma vez, depois as agrupa em esqueletos — mais rápido, porém menos preciso em cenas com muitas pessoas).
3 Elevação 2D para 3D
Após a detecção dos pontos-chave 2D, o sistema precisa inferir a profundidade — a informação do eixo Z que as imagens 2D não possuem. Esta é a etapa tecnicamente mais desafiadora na captura sem marcadores.
Uma única imagem 2D é inerentemente ambígua quanto à profundidade: um braço estendido em direção à câmera parece semelhante a um braço estendido lateralmente. Para resolver isso, os modelos de estimativa de pose 3D usam uma de duas estratégias:
Métodos baseados em elevação: Uma rede neural treinada com dados pareados de movimento 2D-3D pega a sequência de pontos-chave 2D e a "eleva" para o espaço 3D. Modelos como VideoPose3D e PoseFormer usam informações temporais (vários quadros consecutivos) para desambiguar a profundidade. Precisão típica: 35-45mm de erro médio por articulação.
Ajuste de modelo corporal paramétrico: Em vez de prever coordenadas 3D brutas, o sistema ajusta um modelo corporal humano paramétrico (mais comumente SMPL ou SMPL-X) às observações 2D. SMPL define um corpo por parâmetros de forma e parâmetros de pose. Ao otimizar esses parâmetros para corresponder aos pontos-chave 2D detectados, o sistema produz uma malha corporal 3D consistente com rotações articulares anatomicamente corretas. Precisão: 30-40mm para modelos temporais como MHFormer e MixSTE.
Sistemas com múltiplas câmeras podem contornar a elevação usando triangulação: se o mesmo ponto-chave é visível de dois ou mais ângulos de câmera calibrados, sua posição 3D pode ser calculada geometricamente. É assim que sistemas sem marcadores de nível de pesquisa (Theia3D, Anipose) alcançam precisão próxima à da captura baseada em marcadores.
4 Ajuste do Esqueleto e Retargeting
Os dados de pose 3D — seja da elevação ou do ajuste de modelo — representam um esqueleto genérico. Para animar um personagem 3D específico, esses dados devem passar por retargeting: mapeados das proporções do esqueleto de origem para a estrutura do personagem alvo.
O retargeting envolve:
- Escalonamento do comprimento dos ossos: Ajustar a distância entre as articulações para corresponder às proporções do personagem
- Extração de rotações: Converter posições 3D das articulações em rotações articulares via cinemática inversa (IK)
- Alinhamento do sistema de coordenadas: Corresponder o referencial do esqueleto de origem à pose de ligação esperada pela estrutura do personagem
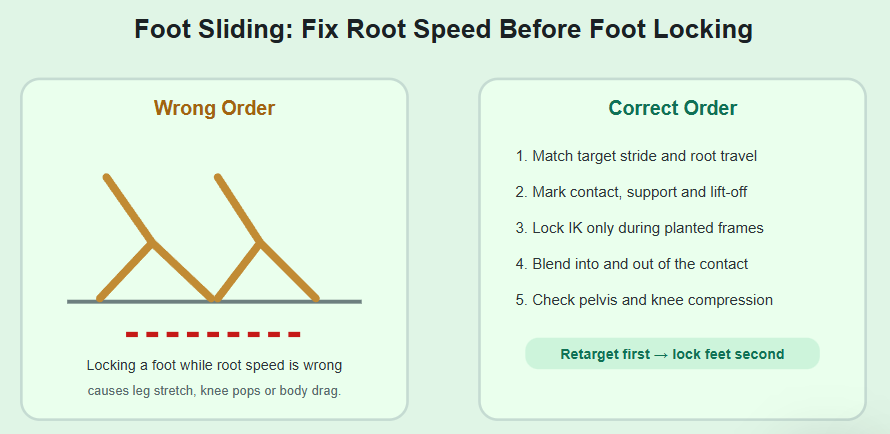
- Tratamento de contato com o pé: Detectar quando os pés tocam o chão e travá-los para evitar deslizamento
Ferramentas como QuickMagic automatizam essa etapa oferecendo exportação direta para formatos de estrutura de personagem, incluindo Mixamo, UE MetaHuman, Character Creator & iClone e Roblox — cada um com perfis de retargeting pré-configurados.
5 Limpeza e Exportação
O estágio final aplica suavização temporal para reduzir tremores, corrige artefatos comuns (deslizamento do pé, estalos nas articulações, interpenetração) e exporta os dados de animação em formatos padrão da indústria.
Operações comuns de limpeza:
- Suavização temporal: Filtros de Kalman ou modelos temporais aprendidos reduzem o tremor quadro a quadro
- Correção de contato com o pé: Detecção e travamento automático dos quadros de contato pé-chão
- Anti-penetração: Ajustar posições das articulações para evitar que membros atravessem uns aos outros
- Loop e corte: Cortar a animação nos quadros inicial e final desejados e, opcionalmente, criar loops contínuos
Formatos de exportação e seus usos típicos:
- FBX — Formato universal de intercâmbio para Maya, Blender, 3ds Max, Unity, Unreal Engine
- BVH — Formato nativo de captura de movimento, amplamente suportado por ferramentas de animação
- BIP — Formato Biped do 3ds Max para fluxos de trabalho do Character Studio
- VMD — Formato MikuMikuDance para conteúdo VTuber e MMD
- UE MetaHuman — Formato de personagem do Unreal Engine 5
- USD — Padrão emergente desenvolvido pela Pixar para cenas 3D
Os Modelos de IA por Trás da Captura sem Marcadores
Modelos de Estimativa de Pose 2D
OpenPose (Carnegie Mellon University)
O primeiro framework de código aberto a alcançar estimativa de pose 2D em tempo real para múltiplas pessoas. Lançado em 2017, utiliza uma abordagem bottom-up com Part Affinity Fields (PAFs) para associar partes do corpo a indivíduos. Detecta 25 pontos-chave do corpo, 70 marcos faciais e 21 pontos-chave por mão. Amplamente usado em pesquisa e como componente em pipelines comerciais.
MediaPipe BlazePose (Google)
Projetado para desempenho em tempo real em dispositivos móveis. Rastreia 33 pontos-chave de corpo inteiro a 30+ FPS em celulares intermediários. Sua arquitetura leve o torna a espinha dorsal de muitos aplicativos de fitness, RA e avatares voltados ao consumidor.
HRNet (Microsoft Research)
A High-Resolution Network mantém representações de alta resolução em toda a rede, em vez de recuperá-las a partir de características de baixa resolução. Esse design confere ao HRNet a maior precisão publicada no benchmark COCO Keypoints. Comumente usado como backbone de detecção 2D em pipelines 3D de nível de pesquisa.
ViTPose
Um estimador de pose baseado em Vision Transformer que superou o HRNet em vários benchmarks. Utiliza mecanismos de autoatenção para capturar o contexto global em todo o corpo, melhorando a precisão em poses complexas com muita auto-oclusão.
Modelos de Pose e Corpo 3D
SMPL (Skinned Multi-Person Linear)
Um modelo corporal paramétrico desenvolvido pelo Max Planck Institute for Intelligent Systems. SMPL representa o corpo humano usando 10 parâmetros de forma (controlando as proporções do corpo) e 72 parâmetros de pose (3 rotações por 24 articulações). Dados esses parâmetros, SMPL produz uma malha 3D completa com deformação realista da pele. SMPL foi recentemente adquirido pela Epic Games (via Meshcapade), sugerindo uma integração mais profunda com o Unreal Engine.
SMPL-X
Uma extensão do SMPL que adiciona articulação das mãos (15 articulações por mão) e expressões faciais. Usado em aplicações que exigem captura de corpo inteiro + mãos + rosto, como avatares VTuber e humanos digitais.
VideoPose3D
Um modelo temporal de estimativa de pose 3D que recebe uma sequência de pontos-chave 2D como entrada e produz trajetórias de pontos-chave 3D. Ao usar convoluções temporais, ele aproveita o contexto do movimento para melhorar a precisão da estimativa de profundidade — trabalhando apenas com detecções 2D, sem necessidade de múltiplas câmeras.
Como as Ferramentas Comerciais Combinam Esses Modelos
Plataformas modernas de captura sem marcadores como QuickMagic não dependem de um único modelo. Em vez disso, elas encadeiam vários modelos especializados em um pipeline de ponta a ponta:
- Detecção de pessoa (YOLO ou similar) — identifica e corta o performer em cada quadro
- Estimativa de pose 2D (variante personalizada de HRNet ou ViTPose) — detecta pontos-chave com alta precisão
- Elevação temporal 3D (rede temporal proprietária) — converte sequência 2D em 3D
- Ajuste do modelo corporal (SMPL ou esqueleto personalizado) — produz rotações articulares consistentes
- Pós-processamento (filtros aprendidos + correções baseadas em regras) — suaviza tremores, corrige deslizamento do pé
- Retargeting e exportação — mapeia para o formato de estrutura alvo
Essa abordagem em múltiplos estágios permite que as ferramentas comerciais atinjam uma qualidade superior à de qualquer modelo individual de código aberto, porque cada estágio é otimizado para sua tarefa específica e treinado com dados de movimento de qualidade profissional.
Captura sem Marcadores vs. Baseada em Marcadores: Principais Diferenças
| Fator de Comparação | Baseado em Marcadores (Óptico) | Sem Marcadores (IA/Visão) |
|---|---|---|
| Hardware Necessário | Câmeras infravermelhas, marcadores refletores, traje | Câmera RGB padrão (celular, webcam, DSLR) |
| Tempo de Configuração | 1-4 horas (calibração, colocação de marcadores) | 1-5 minutos (apontar câmera, gravar) |
| Precisão | Posição submilimétrica, <1 grau de ângulo articular | 10-50mm de posição, 2-5 graus de ângulo articular |
| Custo | $50.000 a $250.000+ | $0 a $50/mês |
| Portabilidade | Instalação fixa em estúdio | Em qualquer lugar com uma câmera |
| Preparação do Performer | Vestir traje, calibração de marcadores | Nenhuma — use roupas do dia a dia |
| Tratamento de Oclusão | Marcadores bloqueados pelo corpo são perdidos | Modelos de IA podem inferir articulações ocluídas |
| Múltiplas Pessoas | Sim (com câmeras suficientes) | Sim (1-2 pessoas com câmera única) |
| Rastreamento de Mãos/Dedos | Sim (com conjuntos de marcadores para mãos) | Sim (menos preciso que o corpo) |
| Visualização em Tempo Real | Sim (sistemas de baixa latência) | Sim (modelos em tempo real) |
| Melhor Para | Cinema AAA, biomecânica, medicina | Jogos independentes, criação de conteúdo, prototipagem |
Para uma comparação mais aprofundada, incluindo sistemas inerciais (baseados em traje), veja nosso guia: Captura de Movimento por IA vs. Mocap Tradicional: Prós e Contras.
Onde a Captura de Movimento sem Marcadores é Usada
Desenvolvimento de Jogos
Estúdios de jogos independentes e de médio porte usam a captura sem marcadores para criar animações de personagens — ciclos de caminhada, movimentos de combate, inquietações ociosas e performances de cenas — sem investir em hardware de captura. Um desenvolvedor pode gravar um vídeo de referência com um celular, processá-lo em uma ferramenta de captura por IA e ter arquivos FBX prontos para animação em menos de 10 minutos. QuickMagic exporta diretamente para as estruturas do Unreal Engine MetaHuman, Unity e Mixamo, eliminando a etapa de retargeting.
Estúdios AAA também usam a captura sem marcadores como complemento aos sistemas ópticos: capturas de referência rápidas para prototipagem, scouts de movimento para pré-visualização e animação em massa de personagens de fundo que não exigem precisão de nível herói.
Cinema e Efeitos Visuais
A captura sem marcadores desempenha dois papéis no cinema: pré-visualização (capturar performances aproximadas no set para planejar cenas antes da sessão óptica cara) e animação de personagens de fundo (cenas de multidão e personagens secundários animados a partir de capturas sem marcadores, reservando os sistemas ópticos para performances principais). O sistema com múltiplas câmeras da Move.ai foi usado em ambientes de produção virtual onde os performers interagem com cenários de paredes de LED.
RV/RA e Avatares Virtuais
O rastreamento sem marcadores em tempo real alimenta avatares de RV, filtros de RA e aplicativos de prova virtual. O modelo corporal de 33 pontos do MediaPipe roda a 30+ FPS em dispositivos móveis, permitindo experiências de RA baseadas em celular que mapeiam os movimentos do usuário para personagens virtuais. VTubers usam rastreamento facial e corporal sem marcadores para controlar avatares digitais durante transmissões ao vivo.
Análise de Desempenho Esportivo
Técnicos e cientistas do esporte usam sistemas sem marcadores para analisar a biomecânica dos atletas — marcha na corrida, mecânica de saltos, cinemática de arremessos — sem instrumentar o atleta. Sistemas como Theia3D e ferramentas construídas sobre OpenPose fornecem dados de ângulo articular que se aproximam da precisão de sistemas ópticos de nível laboratorial (