

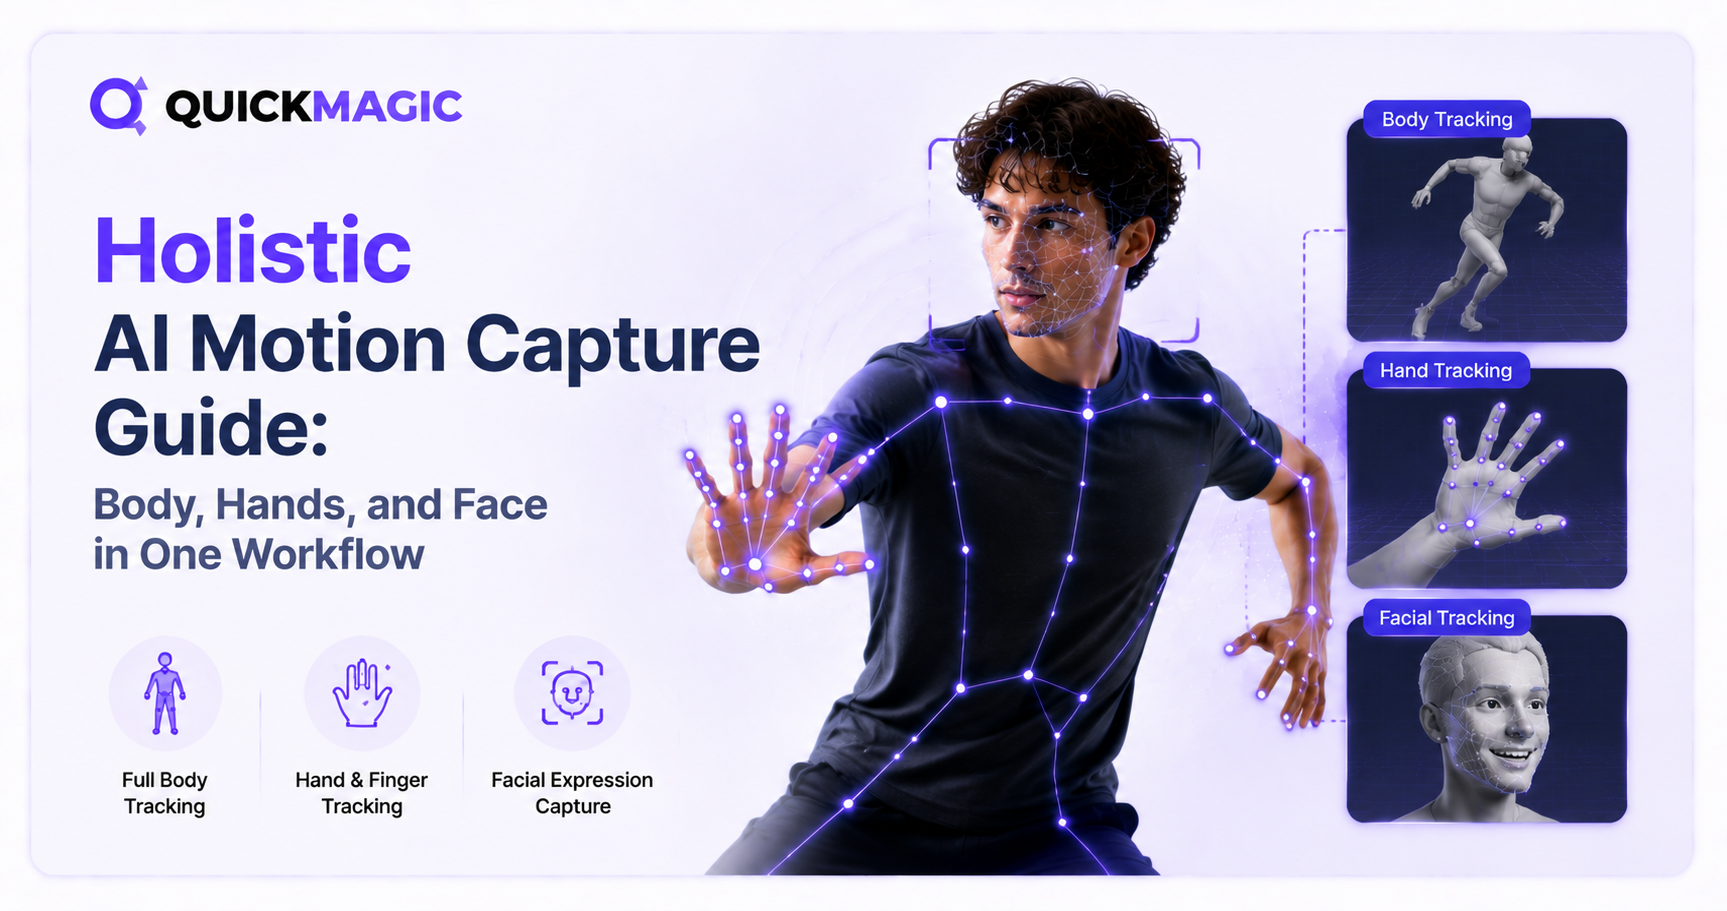
人間の身体は全体としてコミュニケーションを取ります。手を振る動作は、単に腕が動いているだけではありません — 肩の回旋、手首のしなり、指の開き、そして多くの場合は微笑みまでが、すべて同期して起きています。何十年もの間、モーションキャプチャ技術はこれらの信号を別々の問題として扱ってきました。身体用のシステム、手用の別のシステム、顔用のさらに別のシステムです。ホリスティック・モーションキャプチャは、その分断に終止符を打ちます。単一のAIモデルが、1本の動画から全身・手・顔のモーションキャプチャデータを読み取るようになりました — 身体の骨格、指の関節動作、顔のメッシュを、すべて1回の処理で。
本ガイドでは、AIホリスティックトラッキングとは何か、その内部でどのように機能するのか、なぜ分離型のアプローチよりも優れているのか、そしてQuickMagic のようなツールがどのようにしてカメラさえあれば誰でも使えるようにしているのかを解説します。
ホリスティック・モーションキャプチャとは?
ホリスティック・モーションキャプチャとは、単一の動画から、1つの共有AIモデルを用いて身体のポーズ、手のランドマーク、顔のメッシュを同時に推定する統合型のトラッキング手法です。「ホリスティック(全体論的)」という言葉が鍵です — これは、モデルが3つの身体部位をそれぞれ単独でではなく、パフォーマーの全体を一度に理解することを意味します。
ホリスティック・トラッキングモデルは、動画の各フレームから3つの同期したデータストリームを出力します:
- 身体の骨格 — 脊柱、肩、肘、手首、股関節、膝、足首をカバーする33個のジョイント。これにより、歩行、ジャンプ、ダンス、手を伸ばすといった大規模な移動動作を捉えます。
- 手のランドマーク — 片手あたり21点(合計42点)。指の付け根から指先までのすべての関節をカバーします。これにより、握る、ジェスチャー、手話、楽器の演奏といった細かな運動制御を捉えます。
- 顔のメッシュ — 顔全体にわたる468個の高密度な点。視線、眉の動き、リップシンク、頬の変形、微細な表情を捉えます。
合わせると、1フレームあたり543個のトラッキング・ランドマークになります — 1台のカメラから得られる、人間のパフォーマンスの包括的なデジタル表現です。
ホリスティック・モーションキャプチャとは、共有された特徴抽出を備えた統合AIモデルを用いて、単一の動画から身体・手・顔の動きを同時に推定することです。別々のトラッカーを実行してポストプロダクションで結果をつなぎ合わせる分離型のアプローチとは異なり、ホリスティック・キャプチャはキャプチャした瞬間から自然に同期された、空間的に一貫したモーションデータを生成します。
分離型からホリスティックへ:この転換が重要な理由
従来のパフォーマンスキャプチャのパイプラインは分断を前提に構築されていました。典型的なスタジオ構成は、次の要素を組み合わせたものでした:
各システムは独立して動作していました。身体用スーツは手の位置を認識していませんでした。グローブは顔のコンテキストを認識していませんでした。顔用カメラは独自のタイムコードで動作していました。これらをつなぎ合わせて1つのまとまりのあるパフォーマンスにするには、高コストなポストプロダクション作業が必要でした — 手動でのタイムコードの位置合わせ、座標空間の変換、そして互いに一切通信しないシステム間の競合解決です。
根本的な問題はアーキテクチャにありました。パフォーマーについての共通理解を一切持たない3つのモデルです。AIホリスティックトラッキングはこれをモデルのレベルで解決します。
ホリスティックと分離型キャプチャの比較
| 項目</ |
|---|